
文件從前處理、切分、向量化到存入向量資料庫,構成了 RAG 系統建立知識庫的完整流程。前處理將不同來源、格式的原始文件轉換為結構化的乾淨文字;切分依照特定策略,將整篇文件拆解為長度適中、語意完整的片段;向量化透過 Embedding 模型,將每個片段映射為可供計算相似度的向量;向量資料庫則負責儲存這些向量,並建立索引結構,使日後的相似度搜尋得以在大規模資料中快速完成。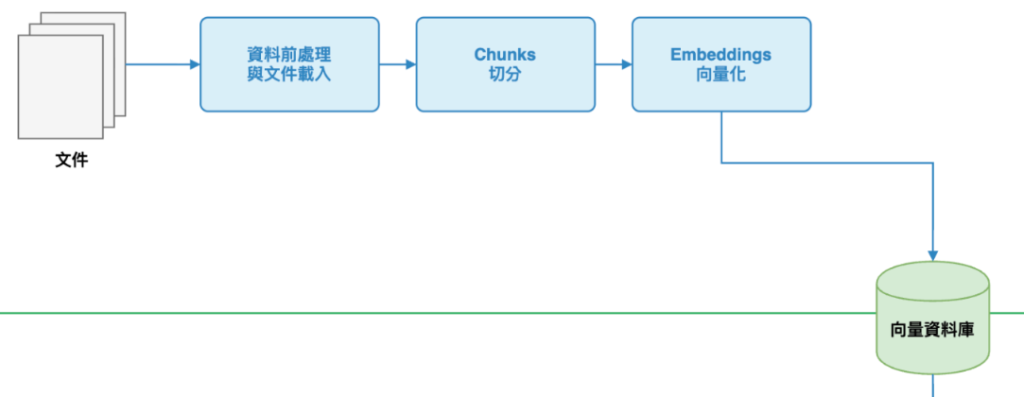
這四個步驟看似各自獨立,實際上彼此緊密相關,任一環節的品質都會直接影響後續環節,甚至最終的檢索結果。前處理若未妥善過濾雜訊、還原文件結構,切分階段便難以依據正確的段落邊界進行拆解,容易產生語意不完整的片段。片段的切分粒度,則決定了向量化之後每個向量所能代表的語意範圍——過細的片段可能遺失上下文,過粗的片段則會讓向量承載過多不相關的資訊,使相似度計算失去鑑別度。向量化階段選用的 Embedding 模型,其表達品質與語言支援程度,直接決定了整個語意空間的準確性;而索引與查詢必須使用同一模型,則是這個語意空間得以成立的前提。向量資料庫的索引結構雖然解決了搜尋效率的問題,但近似最近鄰搜尋本身即是以犧牲部分精確度換取速度,若前面幾個步驟已經產生品質不佳的向量,這種近似性只會讓問題更難被發現。
索引階段的每一項決策,因此共同決定了知識庫所能提供的資訊上限;無論後續的檢索與生成機制設計得多麼精巧,都無法從品質不佳的知識庫中,取得原本就不存在的正確資訊。


 iThome鐵人賽
 看影片追技術